字节跳动开源的端到端唇形同步模型,以音频条件潜扩散生成对口型视频
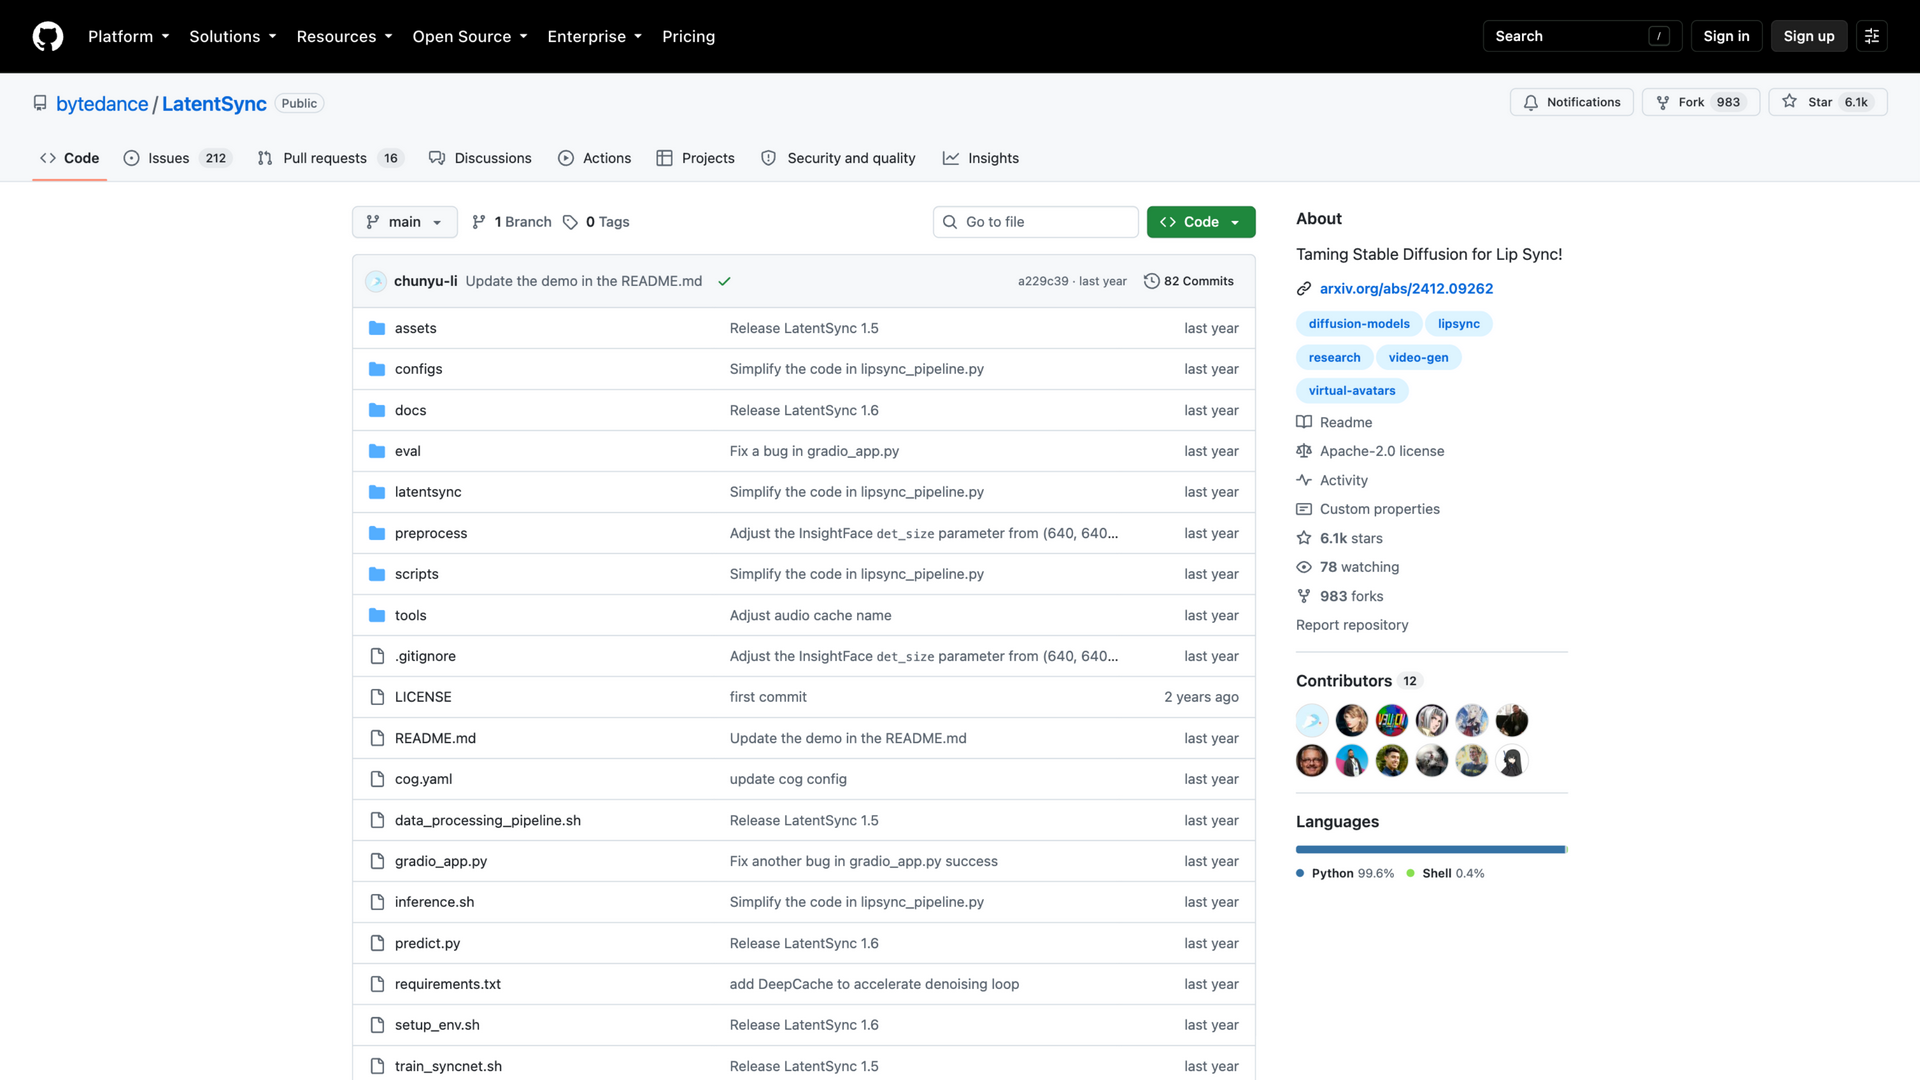
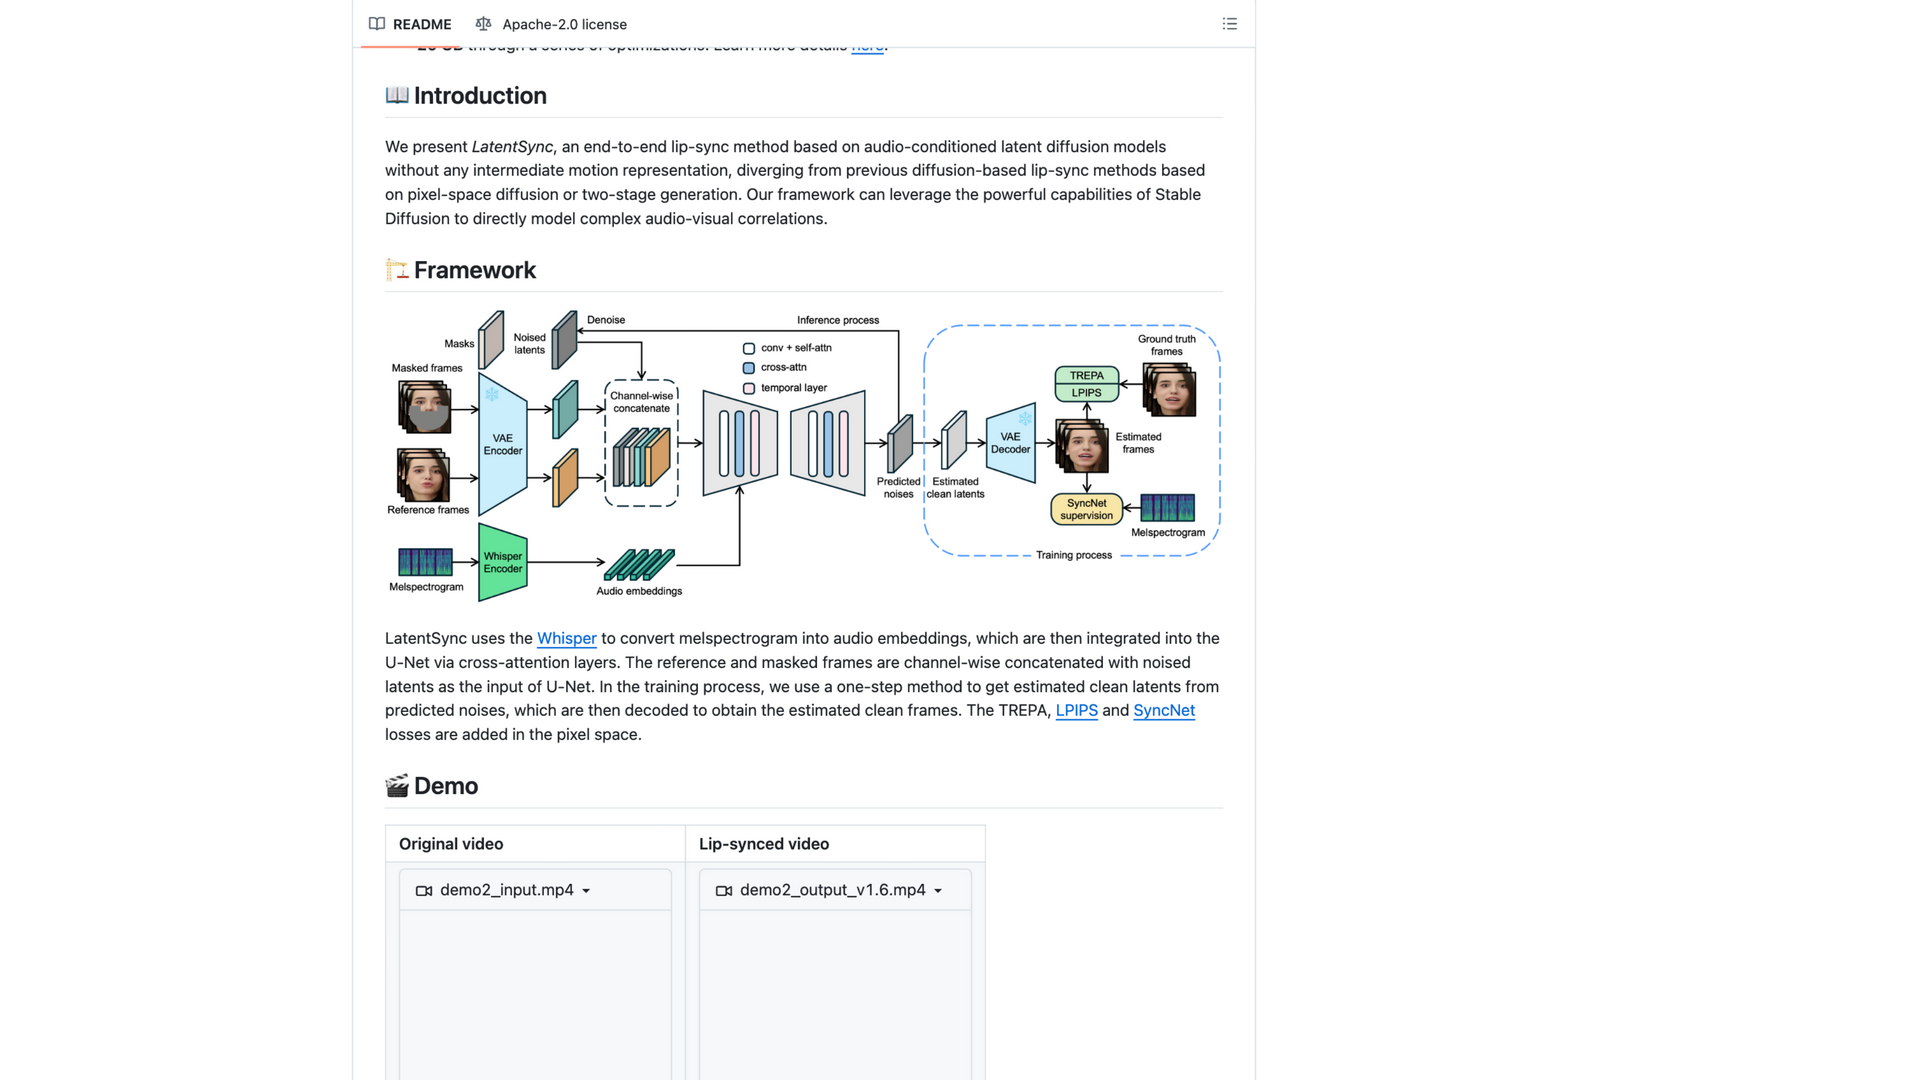
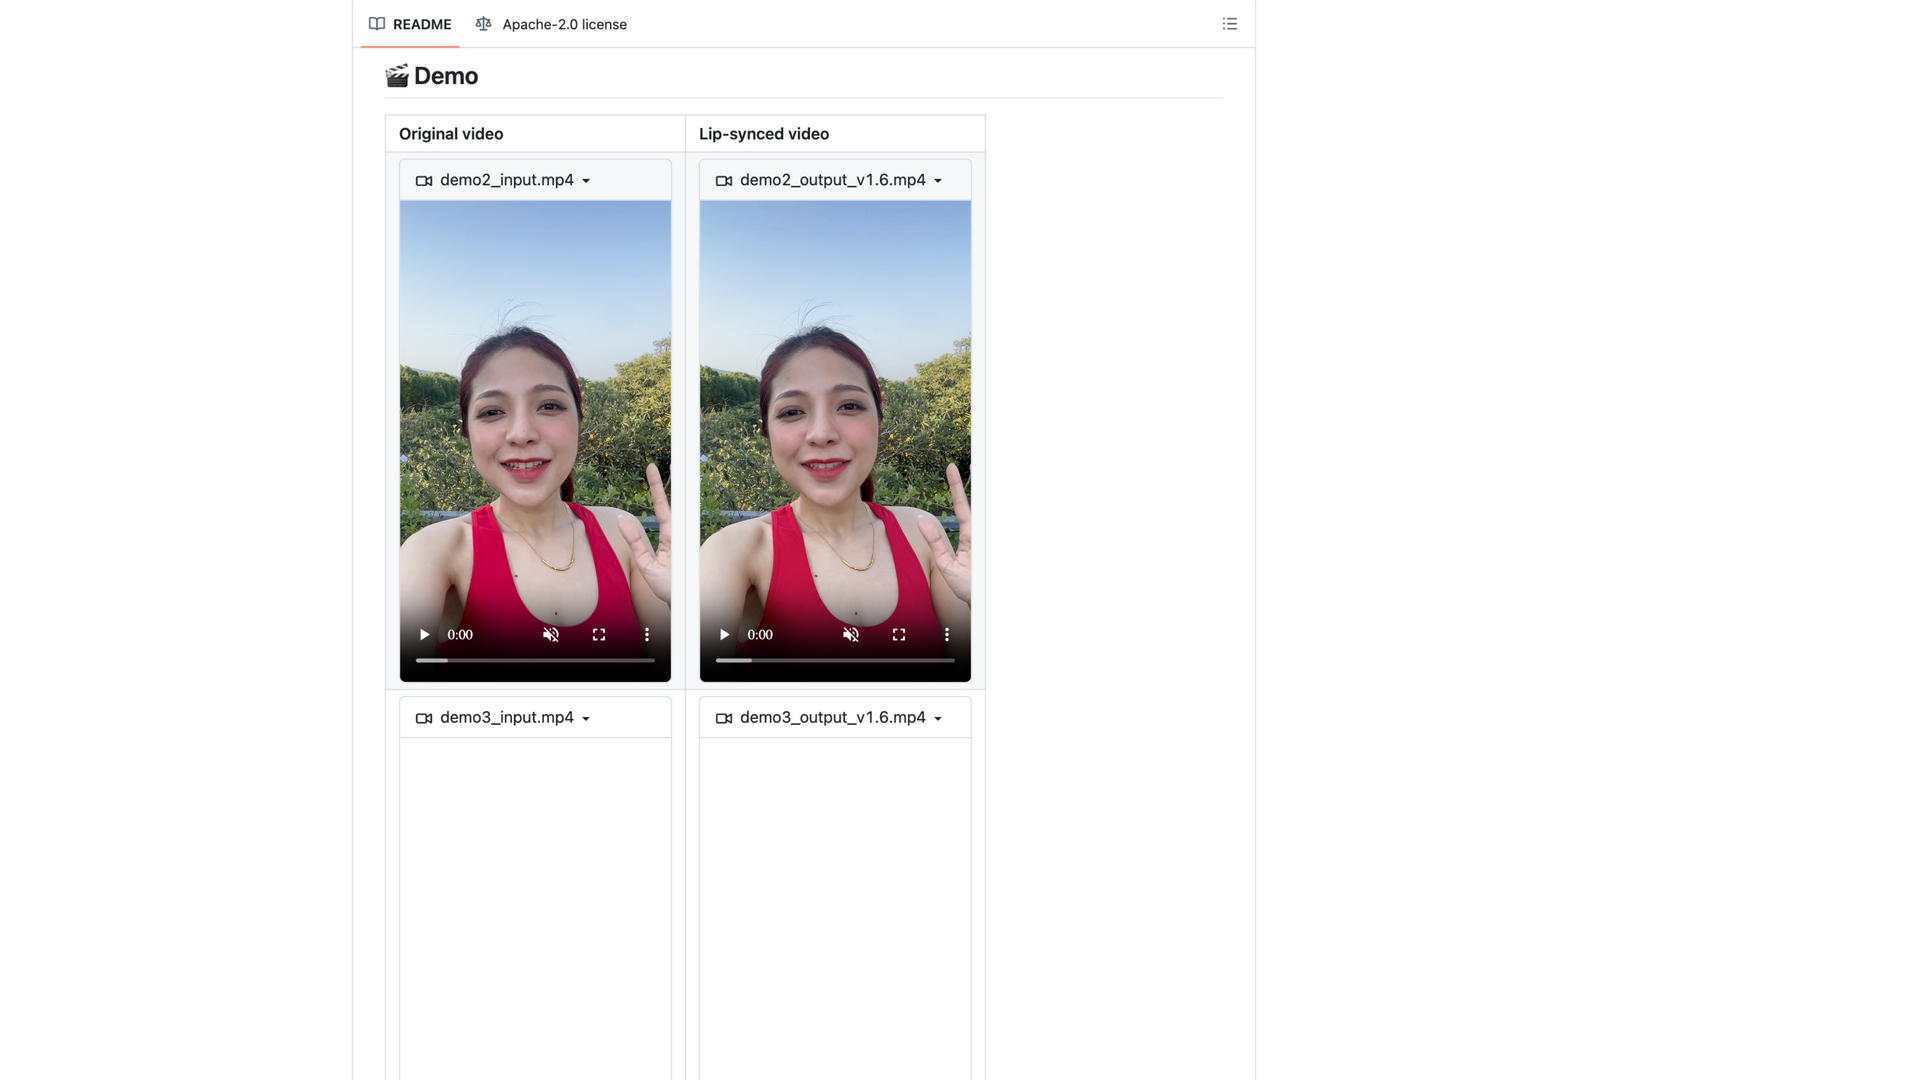
LatentSync 是字节跳动开源的端到端唇形同步方法(Apache-2.0),基于音频条件 潜扩散模型直接建模音视频关联,不做中间运动表示,仓库标语 "Taming Stable Diffusion for Lip Sync!"。框架以 Whisper 把 mel 频谱转为音频嵌入、经 cross-attention 注入 U-Net,训练在像素空间加 TREPA/LPIPS/SyncNet 损失。推理、数据处理管线与 U-Net、 SyncNet 训练代码均已开源,支持 Gradio 应用与命令行推理(1.6 最低 18GB 显存),模型 权重公开在 HuggingFace;最新版 1.6(2025/06)以 512×512 分辨率训练缓解画面模糊, 1.5 版起改善中文视频表现。GitHub 6.1k stars(2026-10-06),主分支最后提交 2025-06-20,此后未再更新。
暂无相关文章。