开源 GPU 集群管理器,为 AI 模型服务编排 vLLM 等推理引擎
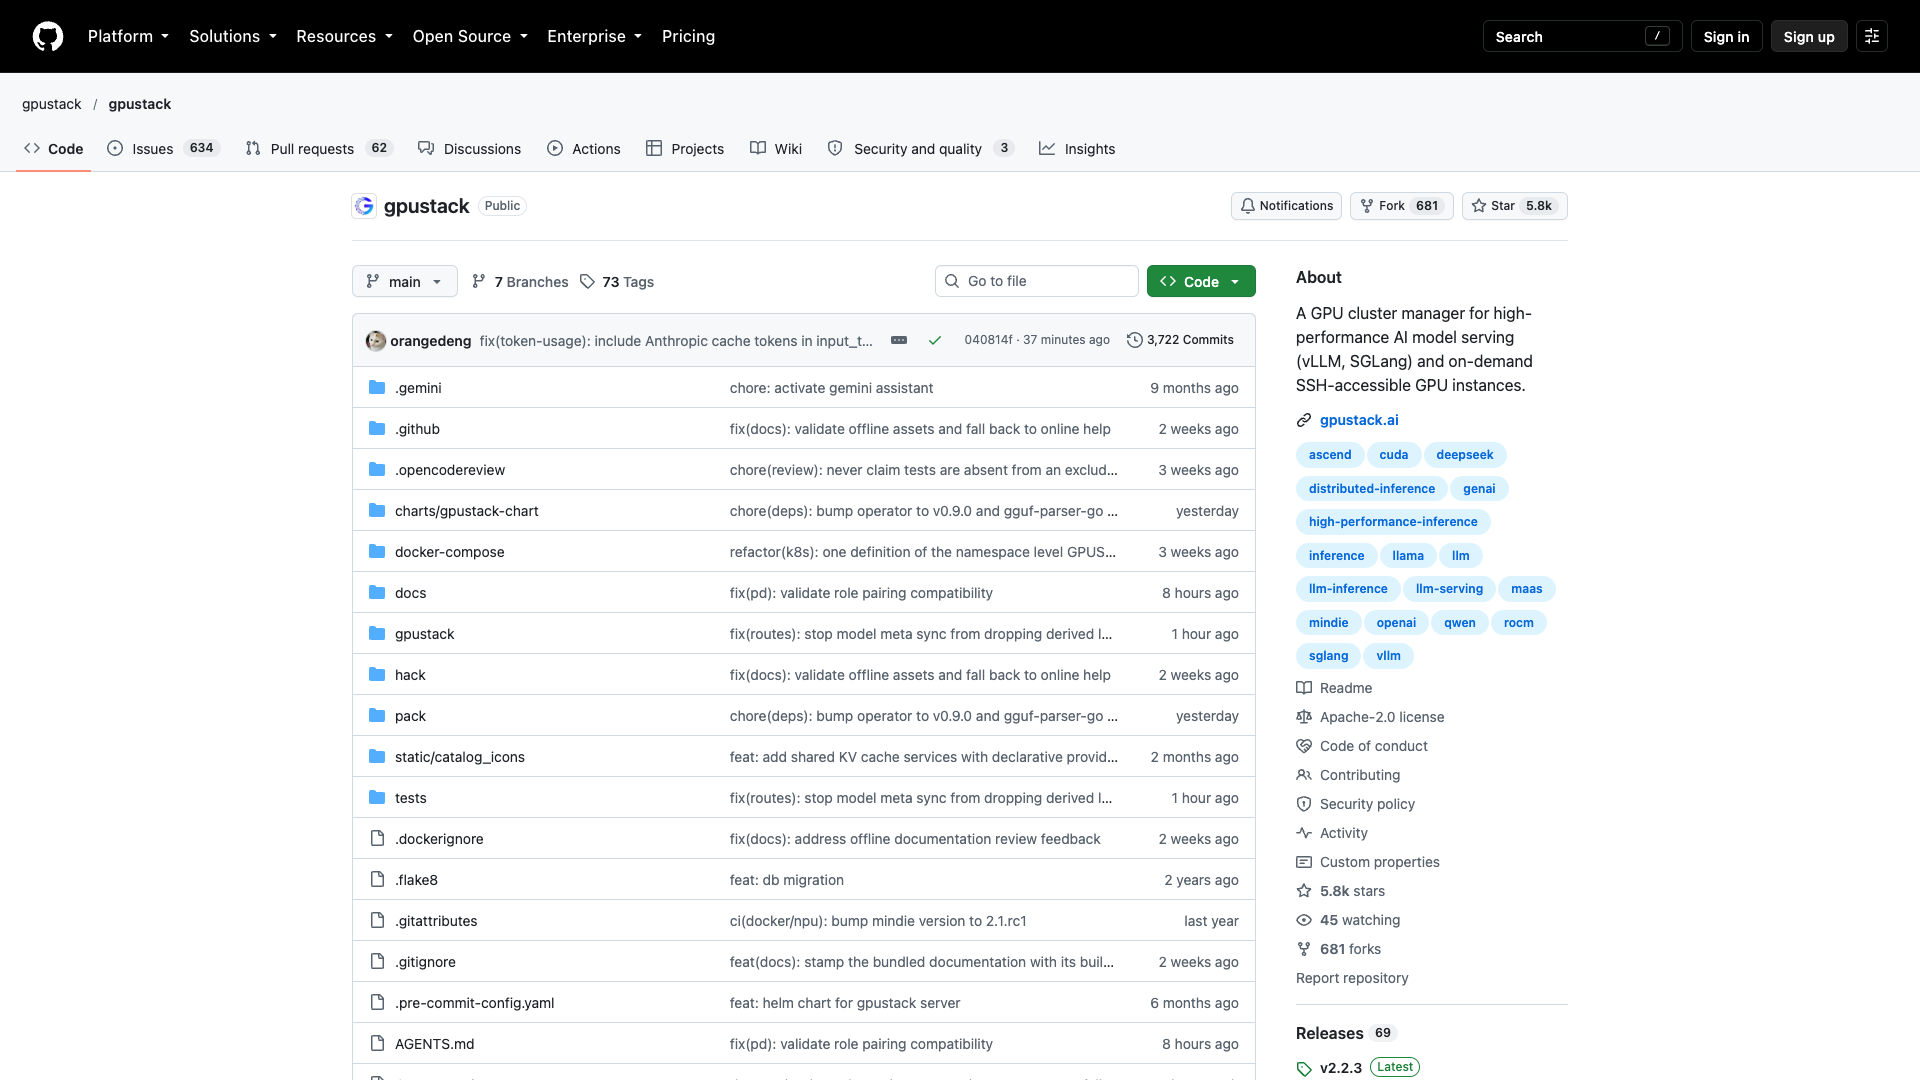
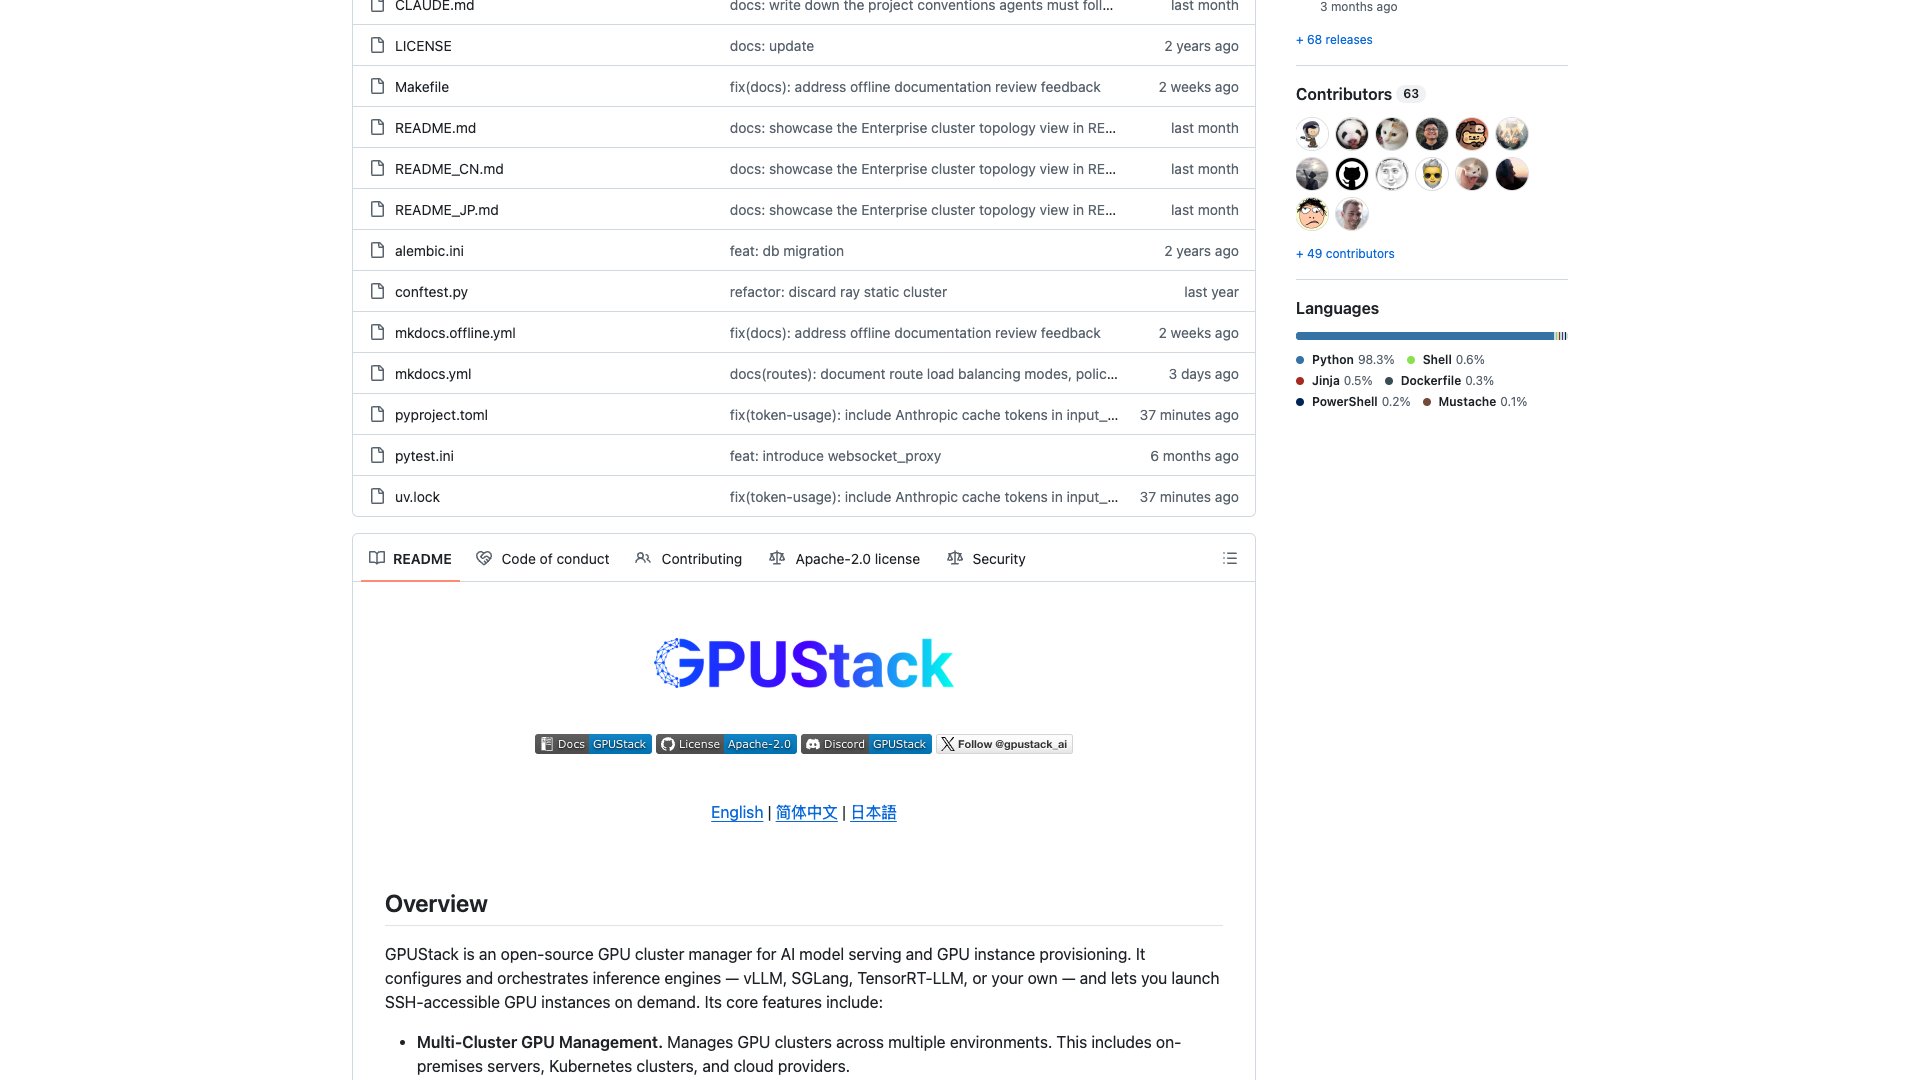
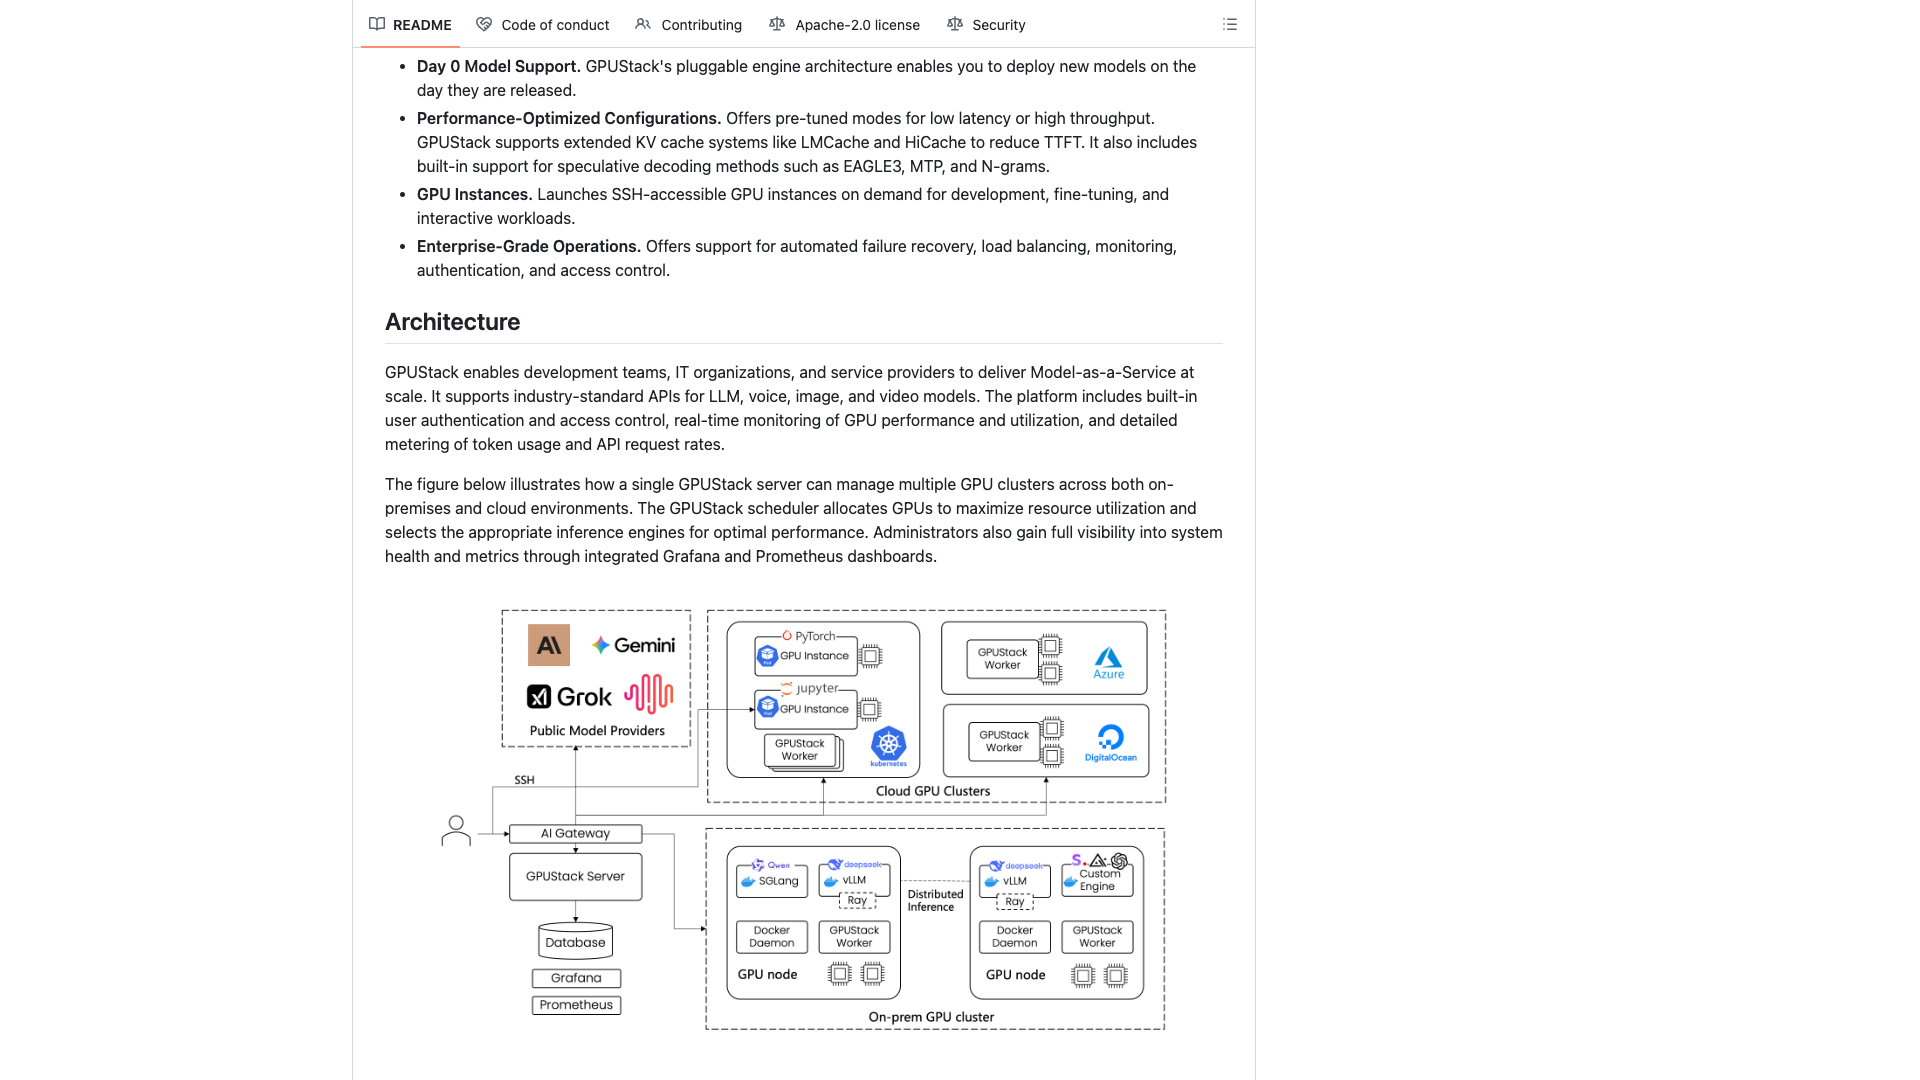
开源 GPU 集群管理器,负责 AI 模型服务与 GPU 实例供给:配置并编排 vLLM、SGLang、TensorRT-LLM 等推理引擎,也能按需启动 SSH 可访问的 GPU 实例,用于开发、微调与交互式工作负载。跨本地服务器、Kubernetes 与云厂商 管理 GPU 集群,可插拔引擎架构让新模型发布当天即可部署,提供低延迟/高吞吐 预调模式,LMCache、HiCache 扩展 KV cache 降低 TTFT,并内置 EAGLE3、MTP、 N-grams 投机解码。企业级运营方面提供自动故障恢复、负载均衡、监控、认证与 访问控制,token 用量与 API 请求速率也有计量,另集成 Grafana 与 Prometheus 仪表盘。Apache-2.0 协议,GitHub 5.8k star(2026-10-14), README 提供简体中文与日文版,支持 NVIDIA、AMD GPU 及 Ascend NPU、 Cambricon MLU 等加速卡。
暂无相关文章。