LLM 压缩、部署与服务的开源工具箱,自研 TurboMind 推理引擎
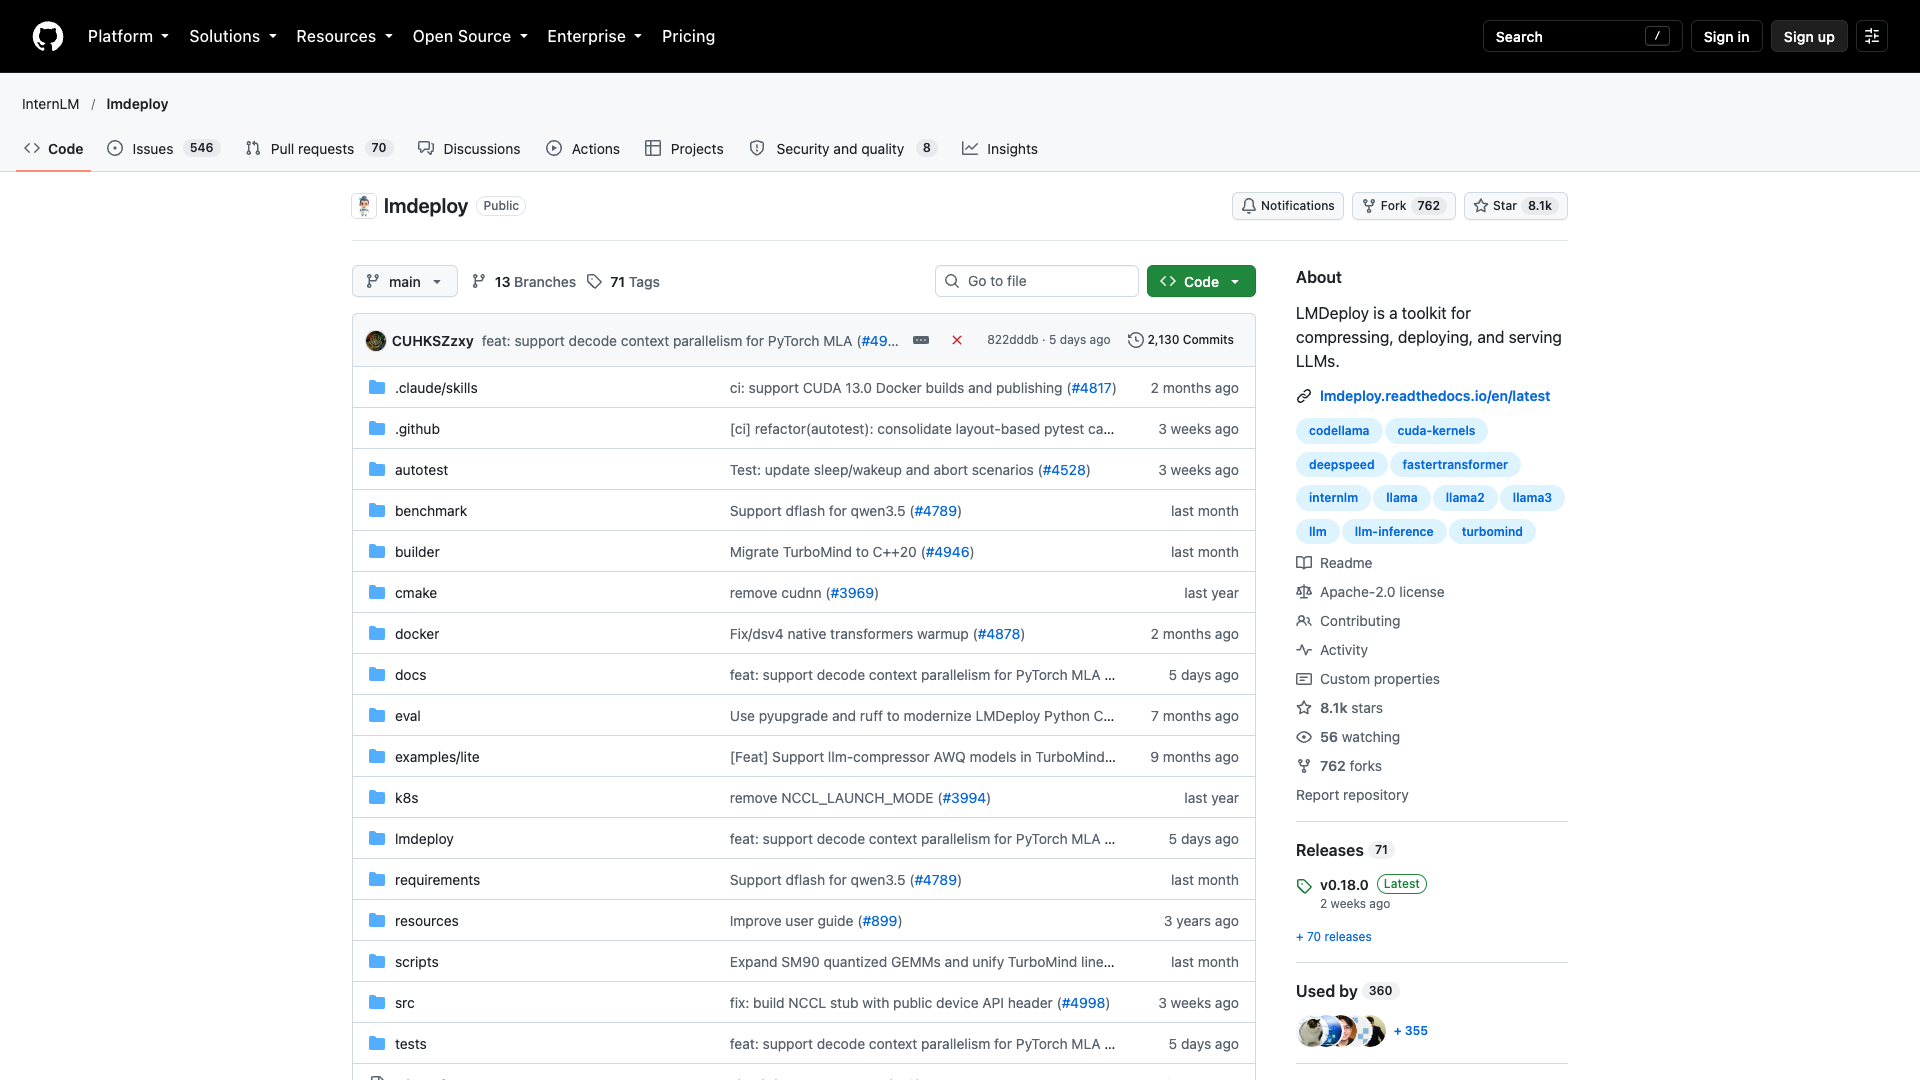
LMDeploy 由 MMRazor 与 MMDeploy 团队开发,官方定位是 "a toolkit for compressing, deploying, and serving LLM",Apache-2.0 协议开源,conda 环境 pip install lmdeploy 即装(Python 3.10-3.13)。内置 TurboMind 与 PyTorch 两个推理引擎,前者专注推理性能优化,后者纯 Python 实现以降低上手门槛; 支持 persistent batch(连续批处理)、blocked KV cache、tensor parallelism, 以及 weight-only 与 k/v 量化——站方称 4-bit 推理性能为 FP16 的 2.4 倍, 量化质量经 OpenCompass 评测确认。请求分发服务支持多模型服务跨多机多卡部署, KV Cache Quant、AWQ 与 Automatic Prefix Caching 可同时开启。支持 Llama、 Qwen、DeepSeek、GLM、InternLM 等主流大模型与 LLaVA、Qwen-VL、InternVL 等多模态模型;TurboMind 混合精度推理论文于 2026 年 8 月被 EuroSys 2027 接收。

暂无相关文章。