CPU-GPU 异构的大模型推理与微调框架,热专家上 GPU、冷专家上 CPU
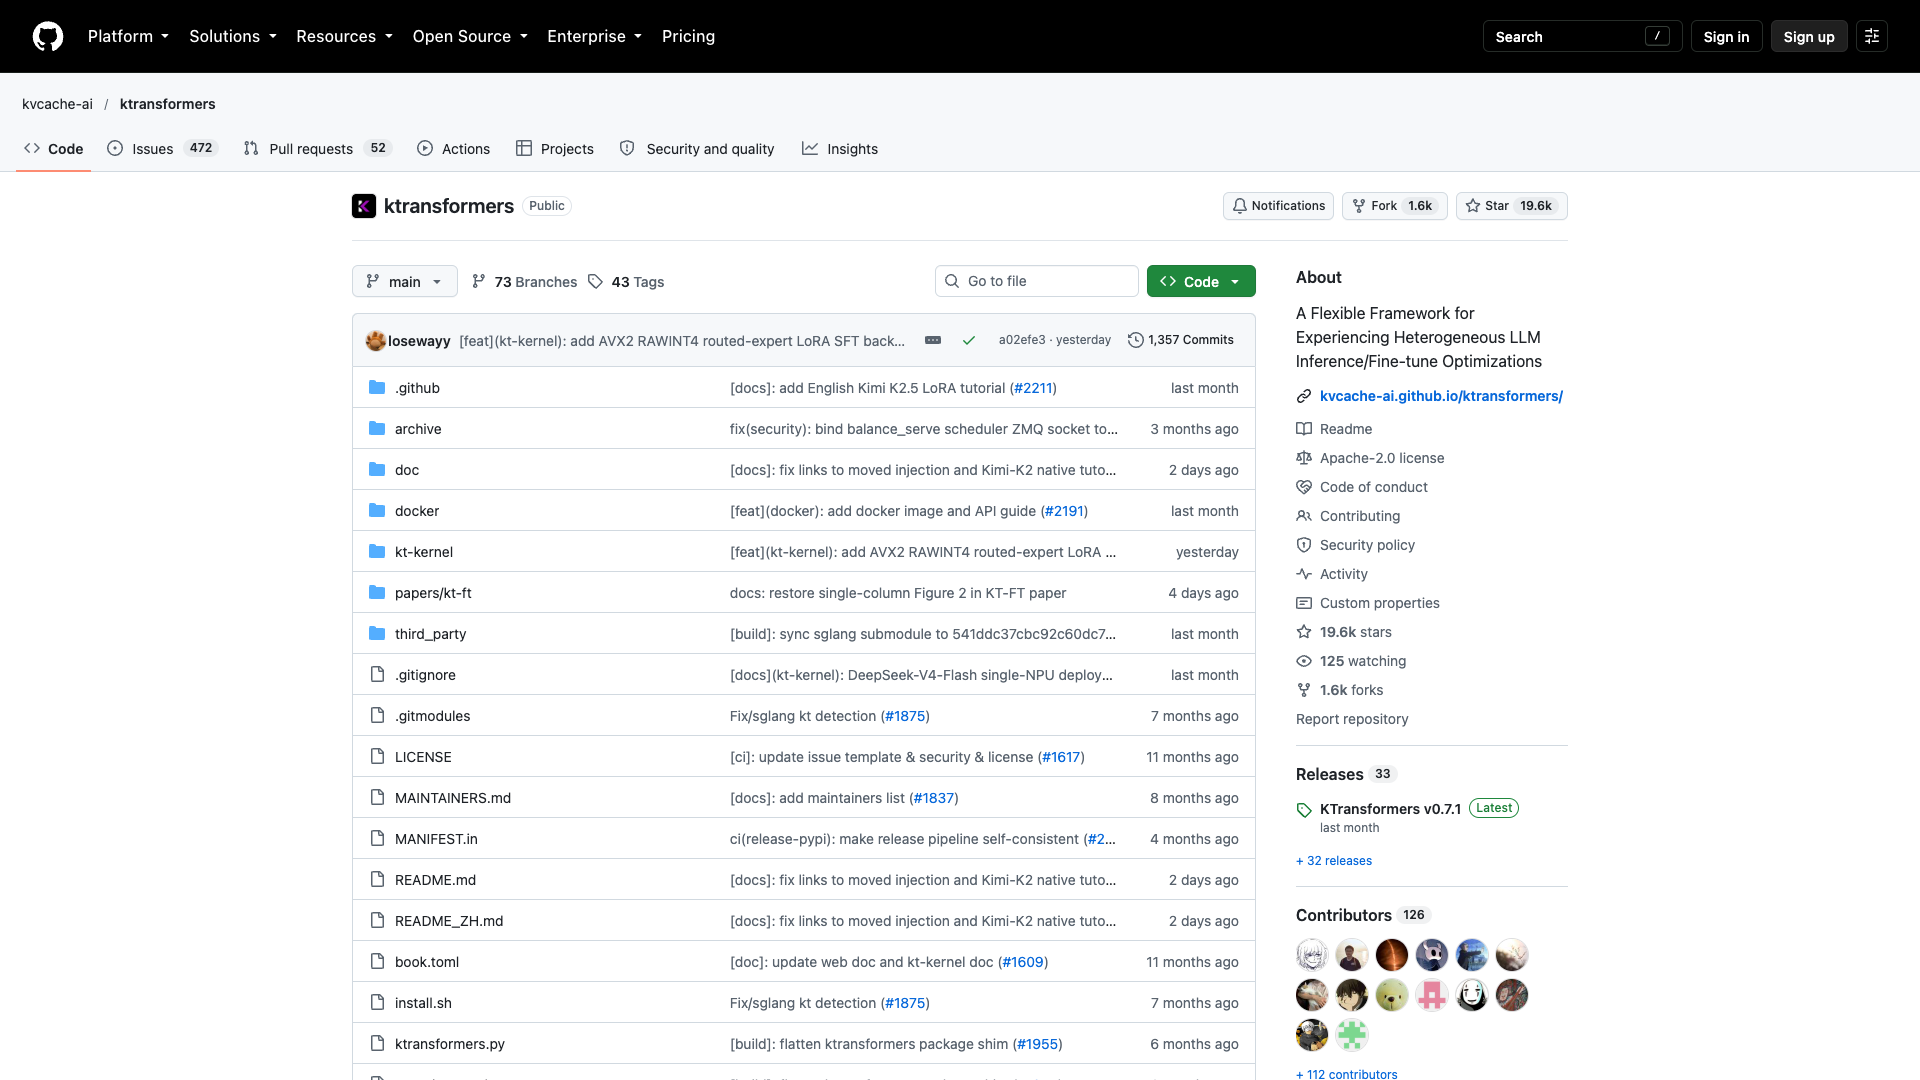
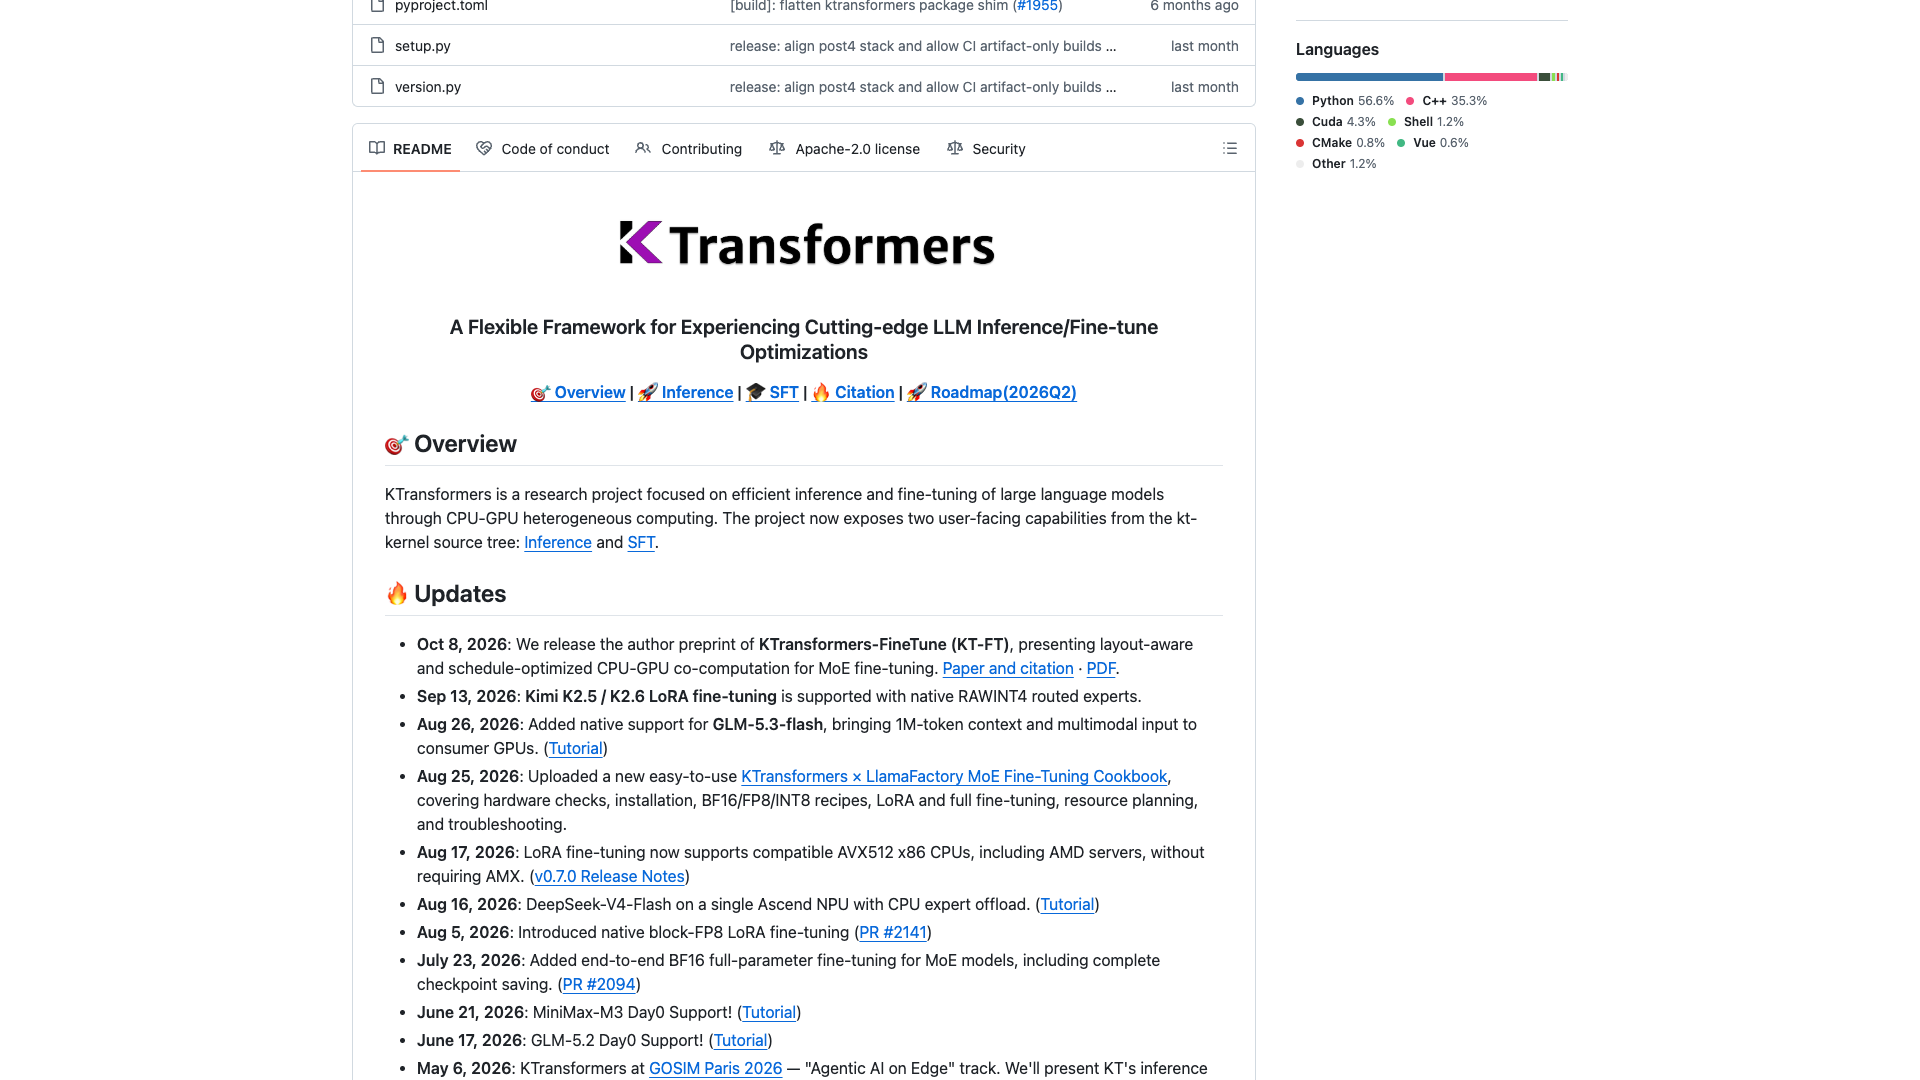
开源研究项目,用 CPU-GPU 异构计算做大语言模型的高效推理与微调, Apache-2.0 协议,19.6k star(2026-10-14),README 署名由清华大学 MADSys 实验室、Approaching.AI 等团队开发维护。kt-kernel 内核提供 Inference 与 SFT 两项能力:推理侧以 Intel AMX 与 AVX512/AVX2 优化内核跑 INT4/INT8 量化推理,MoE 推理做 NUMA-aware 内存管理,热专家放 GPU、冷专家放 CPU, 并以 Python API 接入 SGLang。微调侧经 LlamaFactory 集成,可在有限显存下 微调 DeepSeek-V3/R1 等超大 MoE 模型,站方称在实测的 MoE SFT 负载中 "较 ZeRO-Offload 提速 6-12 倍",新模型常发布当日跟进(Day0 Support)。 站方实测 DeepSeek-R1-0528(FP8)在 8×L20 GPU 加 Xeon Gold 6454S 上 总吞吐 227.85 tokens/s(8 路并发输出 87.58 tokens/s)。
暂无相关文章。