开源端到端语音识别工具箱,覆盖离线、流式与边缘部署及说话人分离
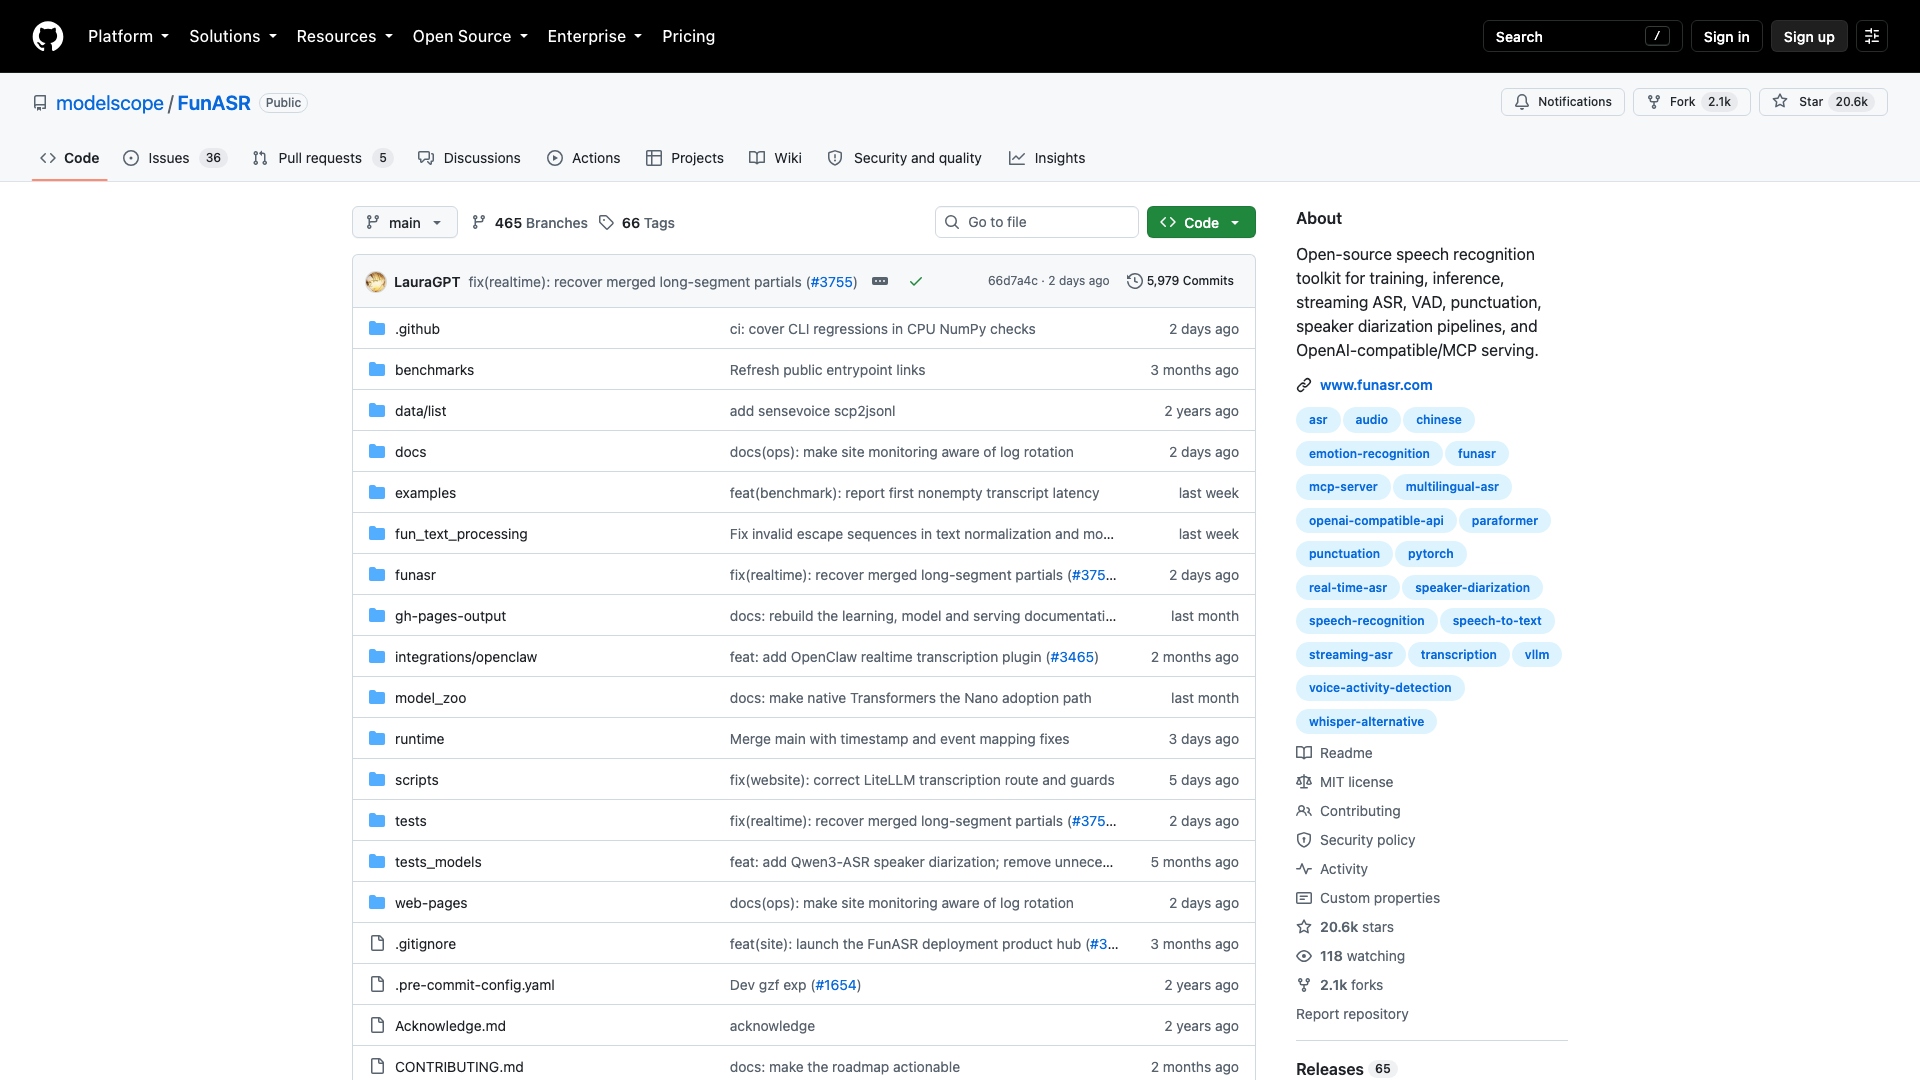
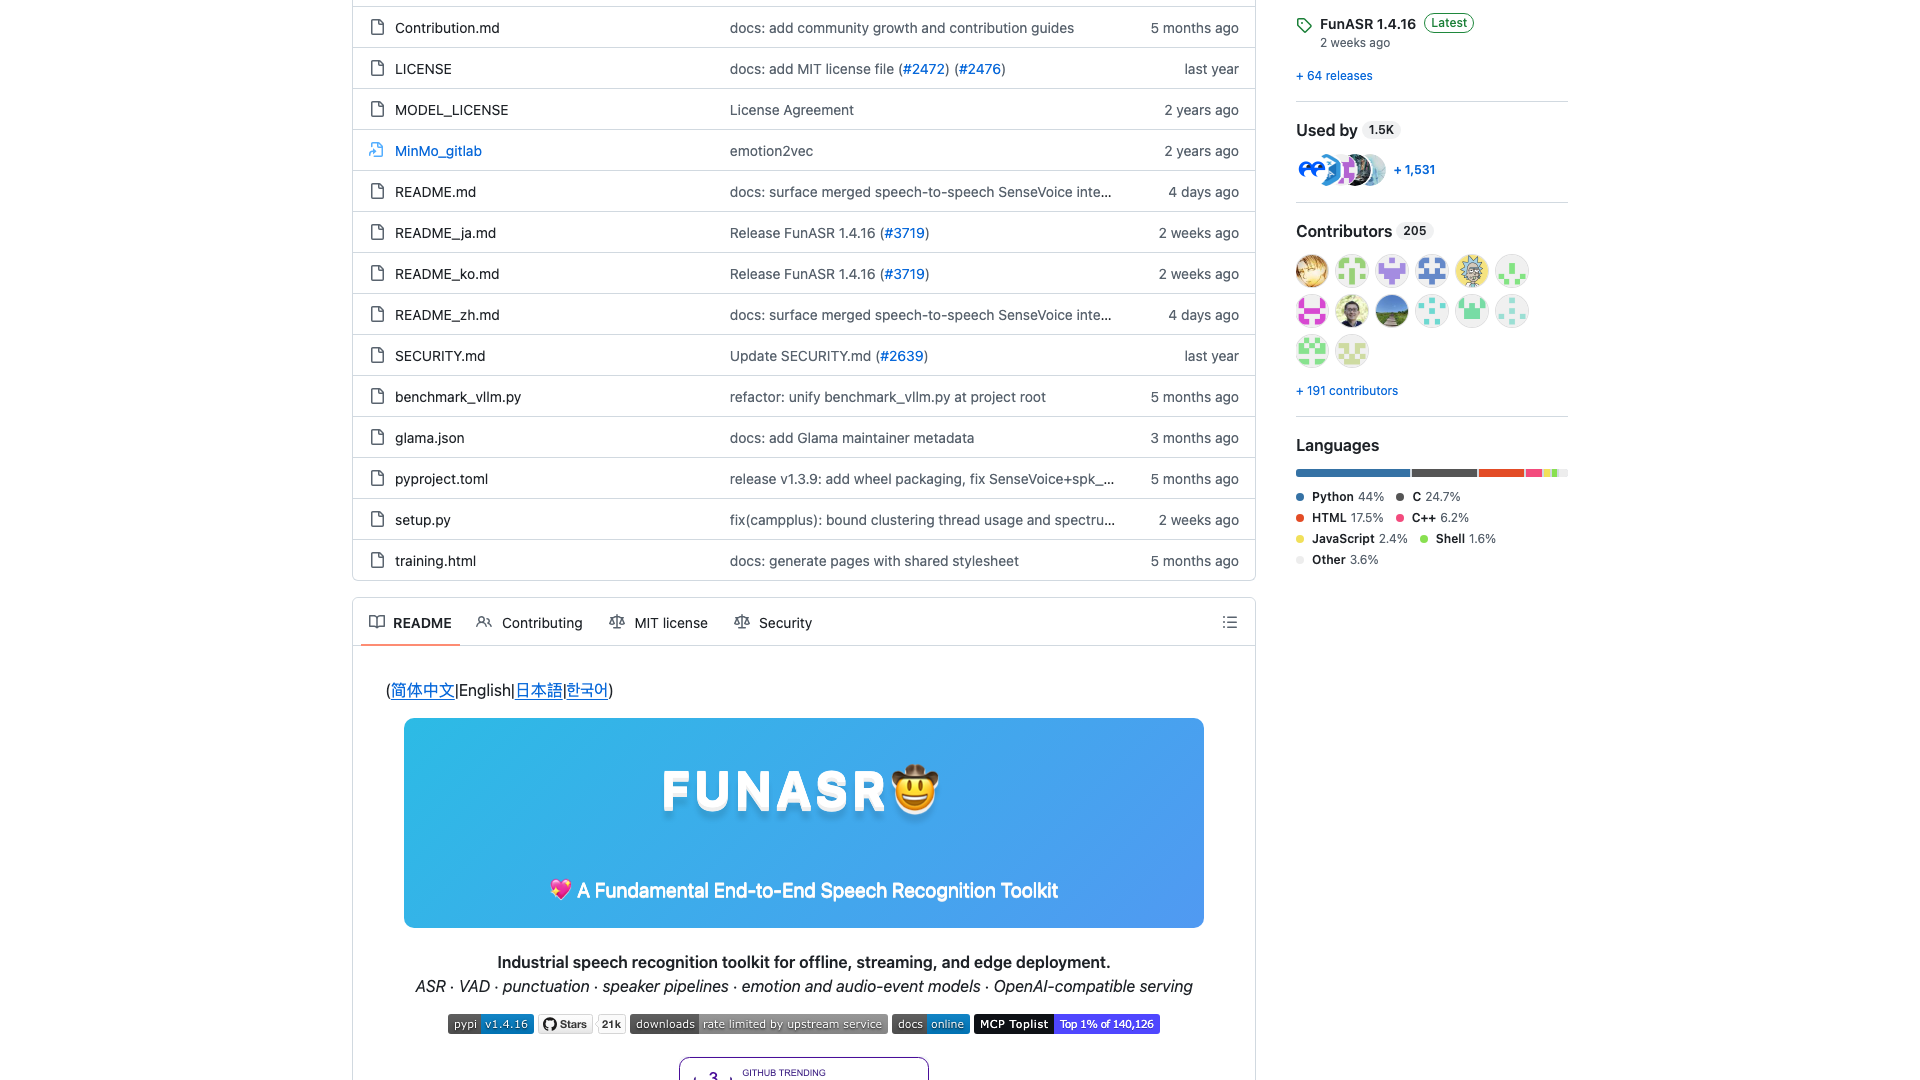
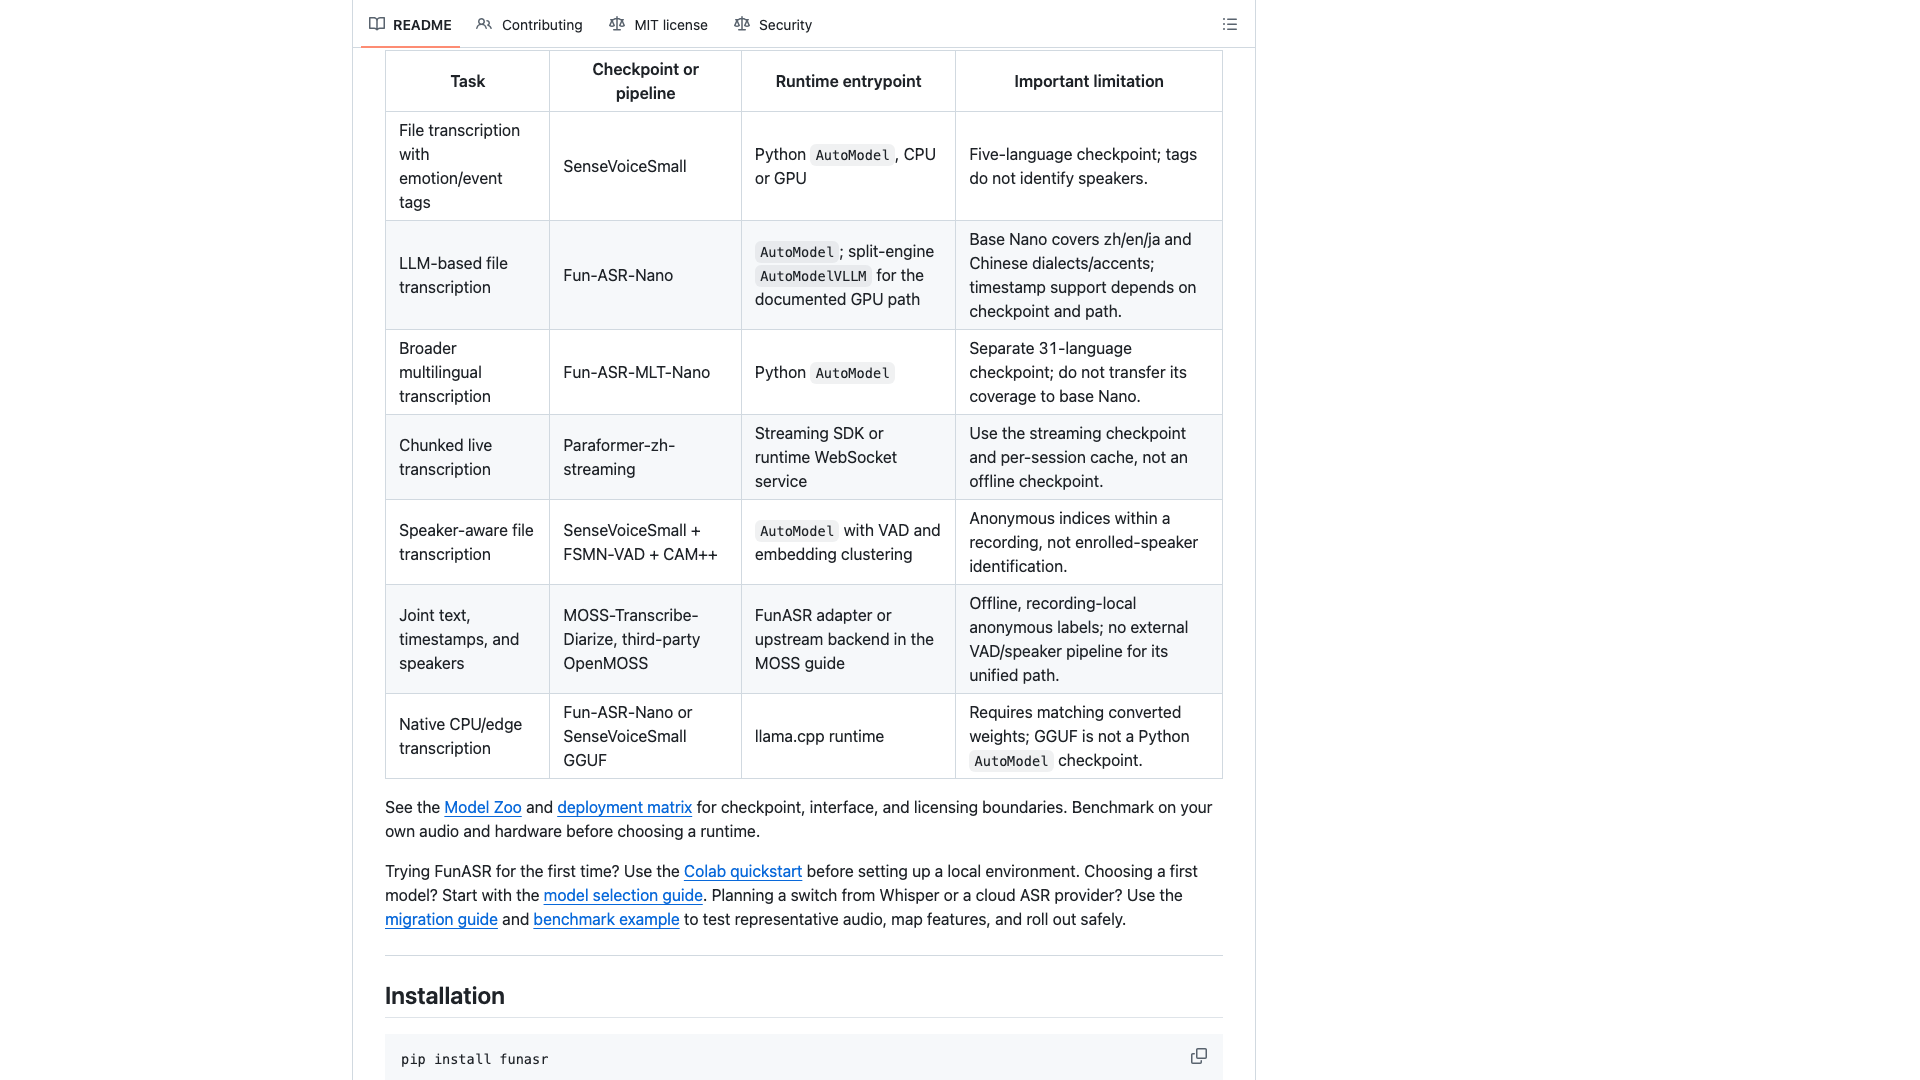
FunASR 是 modelscope org 下的开源语音识别工具箱,代码 MIT 许可 (模型协议另立),GitHub 20.6k stars,README 自述 "Industrial speech recognition toolkit for offline, streaming, and edge deployment"。能力覆盖 文件转写、流式识别、VAD、标点与说话人分离:SenseVoiceSmall 五语转写并输出 情绪与音频事件标签,Fun-ASR 系列覆盖 31 语种,Paraformer-zh-streaming 做 分块实时转写,模型可导出 GGUF 经 llama.cpp 在 CPU 与边缘设备运行。开发侧 pip install funasr 即可推理,另有 MCP Server(Claude/Cursor)、OpenAI 兼容 API(LangChain/Dify/AutoGen)与 OpenClaw 实时转写插件,旗舰模型支持 vLLM 批量加速。官网自称「可私有化部署的语音智能基础设施」,标语「让语音, 成为可用的信息」,并按官网口径称语音识别模型由达摩院推出。
暂无相关文章。